AI Job Automation
Self-hosted система автоматизации поиска работы с локальным AI: сбор и анализ вакансий, logical grouping, Web UI для triage и откликов, статистика и DB-first CRM-синхронизация.
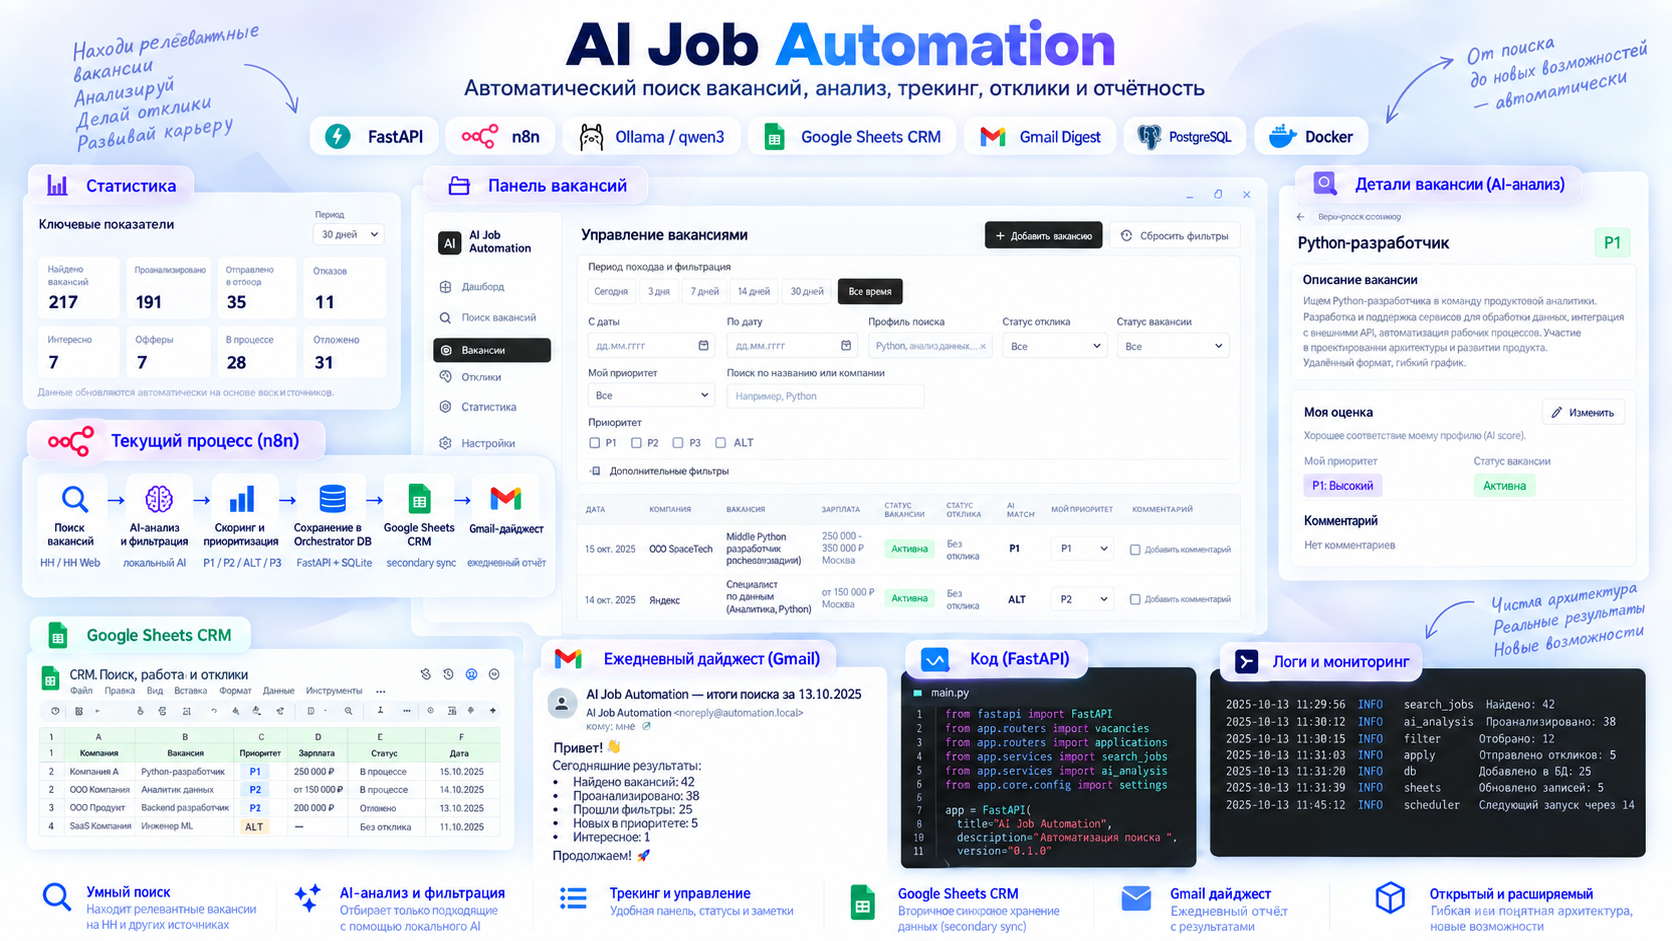
Скриншоты проекта
О проекте
AI Job Automation — self-hosted система автоматизации и управления поиском работы. Она объединяет сбор вакансий, локальный AI-анализ, детерминированный scoring, logical grouping региональных дублей, Web UI для triage и откликов, статистику и DB-first синхронизацию с Google Sheets CRM. Архитектура разделена на несколько компонентов. Worker собирает и обогащает вакансии, выполняет предварительную фильтрацию, semantic assessment через локальную модель Qwen3 в Ollama и рассчитывает итоговый приоритет. Orchestrator API хранит canonical vacancies, результаты анализа, пользовательские оценки, Applications, sync state и статистику. React Web UI используется как основной рабочий интерфейс для просмотра вакансий, изменения статусов и приоритетов, ведения откликов и анализа статистики. n8n отвечает за orchestration и внешние интеграции — Google Sheets CRM и Gmail digest. В проекте используется гибридный подход к оценке вакансий: проверяемые признаки извлекаются Python-кодом, а локальная LLM отвечает за семантический анализ задач, характера роли и соответствия целевому профилю. Итоговый score, hard blockers и AI priority рассчитываются детерминированно, поэтому решение не делегируется модели целиком. Отдельно реализована работа с logical vacancies: региональные копии одной вакансии объединяются в одно представление, чтобы не раздувать список, CRM и статистику. Пользовательская оценка хранится независимо от AI-оценки и включает собственный приоритет, статус вакансии и комментарий. Для ручных вакансий предусмотрен отдельный сценарий: их можно добавить через Web UI, вести по ним Applications и синхронизировать с CRM, но они намеренно не отправляются в AI pipeline. Google Sheets при этом не является source of truth — все изменения сначала сохраняются в Orchestrator DB, а внешняя синхронизация выполняется уже после DB commit.
Какую задачу решает
Сокращает объём ручной работы на всём цикле поиска вакансий: система автоматически собирает новые позиции, объединяет дубли, выполняет первичную фильтрацию и AI-анализ, ранжирует вакансии по релевантности и сохраняет их в единую рабочую базу. После этого пользователь работает уже с отобранным списком: расставляет собственные приоритеты, оставляет комментарии, отслеживает статусы вакансий и откликов, ведёт Applications и смотрит статистику по результатам поиска. Основная цель проекта — не автоматизировать решение за пользователя, а убрать рутинный просмотр сотен предложений и дать удобный shortlist с объяснимой оценкой, рисками и инструментами для дальнейшей работы с подходящими вакансиями.
Что реализовано
- Сбор вакансий HH из авторизованных подборок по резюме, public keyword profiles и расширенного поиска. - Пагинация, нормализация и exact deduplication canonical vacancies. - Logical grouping региональных и business-дублей в единое представление вакансии. - Двухступенчатый анализ: preliminary-фильтрация по краткой карточке и полный анализ перспективных вакансий. - Локальный AI через Ollama и qwen3:4b-instruct. - Гибридная оценка: детерминированное извлечение признаков на Python + semantic assessment через LLM. - Расчёт score, hard blockers и AI priority P1 / P2 / P3 / ALT. - Хранение canonical vacancies, истории анализов, run history, processing events и sync state в Orchestrator DB. - React Web UI для Vacancy List, Vacancy Detail, Applications, manual vacancies и Statistics Dashboard. - Inline triage прямо из списка: пользовательский приоритет, статус вакансии и комментарий. - Отдельный VacancyUserState, независимый от AI-оценки. - Ведение Applications со стадиями отклика, ответа, интервью, тестового, оффера, отказа и отзыва отклика. - Поддержка нескольких Applications и выбор current Application на уровне logical vacancy. - Ручное добавление вакансий из HH, карьерных сайтов, Telegram, прямых контактов и других источников. - Manual vacancies не участвуют в automatic business grouping и намеренно не отправляются в AI pipeline. - n8n-оркестрация полного search pipeline и внешних интеграций. - Preflight-проверки Orchestrator, Worker, Ollama, GPU compute и HH-сессии перед запуском. - DB-first синхронизация VacancyUserState и Applications с Google Sheets CRM. - Автоматическое создание CRM-строки для manual vacancy. - Идемпотентное обновление CRM по CRM Key и controlled fallback для legacy HH-строк. - Persistent CRM sync state со статусами pending / synced / failed и ручным retry. - Gmail-дайджест с результатами запуска, приоритетами, рисками и ссылками. - Statistics Dashboard: найдено, рассмотрено, отклики, ответы, интервью, отказы, активные процессы и офферы. - Фильтрация статистики по периоду: сегодня, 7 / 14 / 30 дней, всё время и custom range. - Обработка частичных ошибок: сбой отдельной вакансии не останавливает весь batch. - Reconciliation пользовательского состояния при изменении presentation key без потери приоритета, статуса и комментария.
Результат
В результате получилась рабочая self-hosted система, которая закрывает не только автоматический поиск и первичный анализ вакансий, но и дальнейшую работу с ними в едином Web UI. Система собирает большой поток вакансий, объединяет дубли, сокращает его до релевантного shortlist, сохраняет историю анализа и позволяет вести дальнейший triage: выставлять собственный приоритет, менять статус вакансии, оставлять комментарии и отслеживать Applications. Orchestrator DB выступает source of truth, а Google Sheets используется как вторичное CRM-представление. Изменения пользовательского состояния и откликов сохраняются в БД по DB-first модели, после чего синхронизируются с CRM. Для внешних ошибок предусмотрены sync state и controlled retry. В реальных production run система обрабатывает крупные выборки вакансий, выполняет локальный AI-анализ и scoring, сохраняет результаты в Orchestrator DB, обновляет CRM и формирует Gmail-дайджест. В Web UI доступны список logical vacancies, детальная карточка вакансии, управление откликами, ручное добавление вакансий и Statistics Dashboard. При этом финальное решение об отклике и сама отправка остаются за пользователем. Автоматизированы сбор, фильтрация, анализ, приоритизация, учёт и синхронизация данных, но не ответственное действие от имени человека.
Практическое применение
Архитектура проекта применима не только к поиску вакансий, но и к другим процессам, где нужно собирать большой поток однотипных данных, устранять дубли, отсеивать шум, выполнять AI-анализ, ранжирование и передавать результат в рабочий интерфейс или CRM. Такой подход подходит для обработки лидов, заявок, тендеров, обращений клиентов, документов, входящих запросов и других бизнес-процессов, где важно сочетать автоматизацию, детерминированные правила, AI-анализ, хранение состояния и ручное принятие финального решения. Отдельные части системы можно переиспользовать как самостоятельные паттерны: DB-first синхронизацию с внешними сервисами, user state поверх AI-оценки, logical grouping дублирующихся сущностей, retry-механику для интеграций, statistics dashboard и разделение тяжёлой обработки между Worker и Orchestrator. Сам проект уже используется как рабочий инструмент для поиска и ведения вакансий: система сокращает время на ручной просмотр, формирует приоритетный shortlist, помогает отслеживать отклики и хранит весь процесс в едином интерфейсе.
Технологии
Python, FastAPI, React, TypeScript, Vite, TanStack Query, SQLAlchemy, Alembic, SQLite, n8n, Ollama, Qwen3, Playwright, Docker, Google Sheets API, Gmail API